




一、万卡智算集群的技术本质与核心价值
万卡智算集群是一种大规模智能计算系统,是人工智能算力基础设施的巅峰形态,其核心在于通过分布式加速卡阵列与超高速网络互联,实现单集群百万亿次浮点运算能力(EFLOPS级)。这种架构突破了单机算力极限,为大模型训练、实时推理等高复杂度任务提供关键支撑。
1.1 技术构成三要素
- 加速卡矩阵:采用异构计算架构,集成数千至数万张AI加速卡(如GPU/NPU),通过PCIe Switch或NVLink实现卡间高速通信。某行业常见技术方案已实现单机柜部署640张加速卡,单机柜功耗达46KW,需配套液冷散热系统。
- RDMA网络:基于InfiniBand或RoCE协议构建无阻塞网络,将节点间通信延迟压缩至微秒级。某国产方案通过自定义拓扑优化,使万卡集群网络带宽利用率突破90%。
- 并行存储系统:采用全闪存阵列与分布式文件系统(如Lustre),满足大模型训练过程中PB级数据的高速读写需求。某创新架构通过数据预取与智能缓存技术,将I/O效率提升3倍。
1.2 算力指标演进
2024年行业基准算力为6.9EFLOPS,至2026年已出现支持10万卡规模的集群设计。以千亿参数大模型训练为例,2.5万卡集群可将训练周期从30天缩短至72小时,单次训练成本降低60%。
2026年,我国已建成万卡智算集群42个,智能算力规模超过1590 EFLOPS。
二、技术发展里程碑与产业格局
2.1 关键节点事件
- 2024年12月:万卡智算集群服务推进方阵成立,制定《智算集群全生命周期管理规范》,涵盖从硬件选型到运维监控的127项标准。
- 2025年2月:某云厂商完成三代加速卡万卡集群部署,采用3D封装技术将单卡算力提升至400TFLOPS,集群整体能效比达3.2GFLOPS/W。
- 2025年12月:某超节点技术方案在行业大会展示真机,通过动态负载均衡算法解决万卡集群中的”长尾延迟”问题,使训练任务完成时间标准差降低至5%以内。
2.2 国产技术突破
- 架构创新:某新一代GPU架构支持10万卡级弹性扩展,通过光互连技术将卡间带宽提升至1.6Tbps,较上一代提升4倍。
- 生态完善:国产算力芯片企业完成港股上市,其自主研发的编译器可自动优化大模型算子,使万卡集群有效算力利用率突破55%。
- 应用落地:某智算中心部署2万张加速卡,实现6.7EFLOPS算力,同时支撑3个千亿参数模型训练与20个百亿参数模型推理。
三、典型应用场景与技术实践
3.1 大模型训练加速
某万亿参数语言模型训练中,万卡集群通过以下技术实现高效运行:
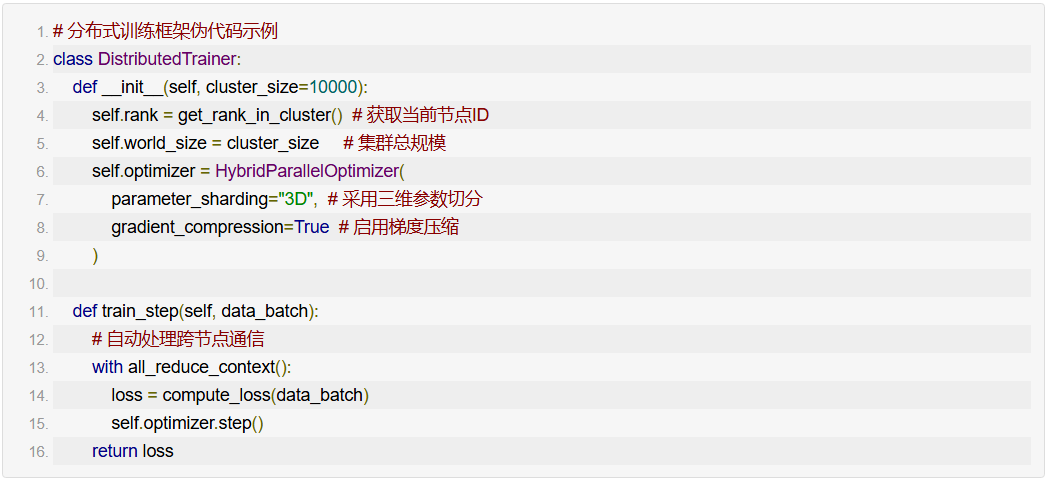
通过混合并行策略(数据并行+模型并行+流水线并行),万卡集群可将单步训练时间控制在0.8秒内,较千卡集群提速8倍。
3.2 智慧城市实时推理
在某省级智慧交通项目中,万卡集群支撑着:
- 2000路视频流的实时分析
- 毫秒级违章行为识别
- 日均10亿次车牌识别请求
技术关键点包括:
- 采用动态批处理技术,根据请求量自动调整批大小(Batch Size)
- 通过模型量化将推理延迟从12ms压缩至3ms
- 部署故障自愈系统,实现99.99%的服务可用性
四、未来发展趋势与挑战
4.1 技术演进方向
- 超万卡集群:某项目规划建设50万卡集群,采用光计算芯片替代传统电子芯片,预计将算力密度提升至当前水平的100倍。
- 绿色算力:通过浸没式液冷与AI功耗优化算法,使万卡集群PUE值降至1.05以下。
- 异构融合:集成CPU、GPU、DPU等多种加速器,构建统一算力资源池。
4.2 产业挑战应对
- 网络可靠性:开发自愈型RDMA协议,在1%节点故障时仍能保持80%以上有效算力。
- 软件生态:构建兼容主流框架的中间件层,解决异构加速卡间的编程差异。
- 成本优化:通过算力虚拟化技术,使万卡集群利用率从当前的40%提升至70%以上。
五、开发者实践指南
5.1 集群部署关键步骤
- 网络拓扑设计:采用胖树(Fat-Tree)架构,确保任意两节点间跳数不超过3
- 存储性能调优:配置SSD缓存层,使小文件读写延迟<50μs
- 监控体系构建:部署全链路监控系统,实时追踪加速卡温度、网络丢包率等200+指标
5.2 性能优化技巧
- 通信优化:使用NCCL通信库替代原生MPI,使All-Reduce操作吞吐量提升30%
- 内存管理:启用CUDA Unified Memory,减少主机-设备间数据拷贝
- 故障处理:实现训练任务自动 checkpoint,故障恢复时间<5分钟
当前,万卡集群已从实验室走向产业化,其技术演进正深刻重塑AI竞争格局。对于开发者而言,掌握分布式训练框架优化、异构计算资源调度等核心技能,将成为驾驭这一超级算力引擎的关键。随着某超节点技术等创新方案的持续突破,万卡集群必将推动人工智能进入全新发展阶段。
猜你喜欢
万卡智算集群
我国算力规模位居全球第二,万卡智算集群建成42个
第三届中国算力网大会在雄安新区举办